
Bir yapay zeka ajanından aldığınız yanıtın “güncel” olmasını mıistersiniz, yoksa “doğru” olmasını mı? Çoğu kullanıcı bu soruyu ilk kez duyduğunda şaşırır; çünkü ikisinin aynı şey olduğunu varsayarız. Oysa bilgi tabanı güncelliği yerinedoğruluk odaklı ajan tasarımı, modern yapay zeka sistemlerinin en kritik ayrımlarından birini oluşturuyor. Güncel bilgi her zaman doğru bilgi anlamına gelmiyor; aynı şekilde doğru bilgi de her zaman en son tarihli kaynaklardan gelmiyor. İşte bu yazıda,doğruluk öncelikli ajan mimarisinin neden önemli olduğunu ve nasıl tasarlanacağını inceliyoruz.
Güncellik ve Doğruluk: Neden Aynı Şey Değil?
Klasik yaklaşımda yapay zeka ajanları, bilgi tabanlarını sürekli güncelleyerek “en taze” veriyi sunmayı hedefler. Ancak pratikte en sık görülen sorun şu: Güncel bir kaynak, yanlış veya eksik bilgi içerebilir. Bir haber sitesindeki son dakika haberi düzeltilmeden önce ajana aktarılabilir ya da sosyal medyadaki viral içerik henüz doğrulanmadan bilgi tabanına girebilir.
Kilit Çıkarım: Güncellik, bilginin “ne zaman” üretildiğiyle ilgiliyken; doğruluk, bilginin “gerçeğe ne kadar uyduğuyla” ilgilidir. İkisi farklı eksenlerdeölçülür.
Stanford Üniversitesi’nin2024 yılındaki araştırması, hukuk alanında kullanılan yapay zeka modellerinin her altı sorguda birinde halüsinasyon ürettiğini ortaya koydu. Bu durum, modelin bilgi tabanının güncel olup olmadığından bağımsız olarak ortaya çıkıyor. Sorun, modelin “bilmediğini bilmemesi” ve güvenle yanlış yanıtlar üretmesidir.
Doğruluk Odaklı Ajan Tasarımının Temel İlkeleri
Doğruluk merkezli bir ajan inşa etmek için birkaç kritik tasarım kararı almak gerekiyor. Bu kararlar, sistemin mimarisinden kullanıcı arayüzüne kadar her katmanı etkiler.
1. Kaynak Doğrulama Katmanı (Source Verification Layer)
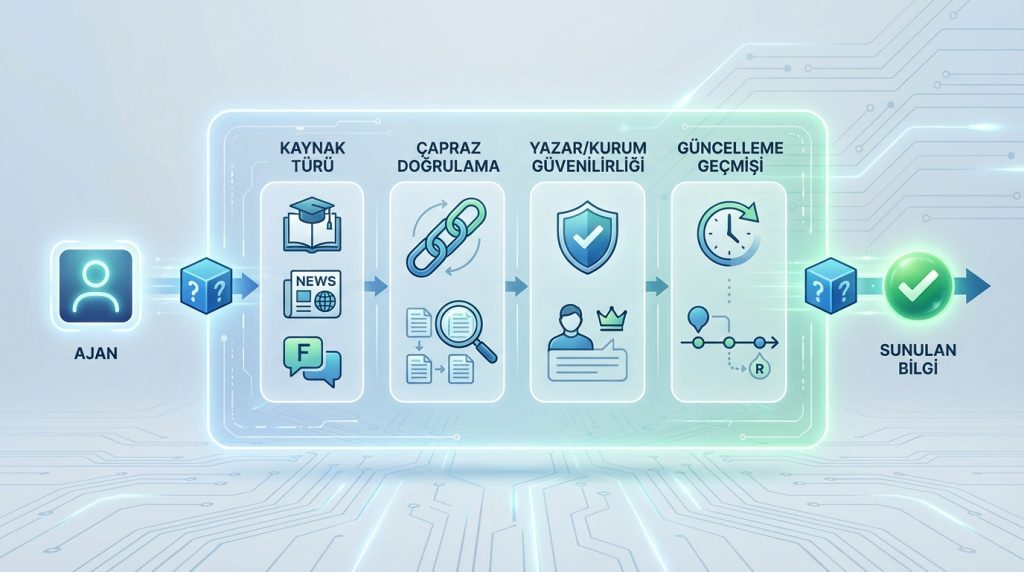
Ajan, bir bilgiyi sunmadan önce kaynağın güvenilirliğini değerlendirmeli. Bu değerlendirme şu kriterleri içerebilir:
- Kaynak türü: Akademik makale mi, haber sitesi mi, forum yazısı mı?
- Çapraz doğrulama: Aynı bilgi birden fazla bağımsız kaynakta var mı?
- Yazar/kurum güvenilirliği: Kaynak, alanında tanınmış bir otorite mi?
- Güncelleme geçmişi: Bilgi daha sonra düzeltilmiş veya geri çekilmiş mi?
2. Belirsizlik İfadesi (Uncertainty Expression)
Doğruluk odaklı bir ajan, bilmediği konularda “bilmiyorum” diyebilmeli. Daha da önemlisi, kısmi bilgiye sahip olduğunda bunu açıkça belirtmeli. Örneğin:
- “Bu konuda kesin bilgi mevcut değil, ancak mevcut verilere göre…”
- “Farklı kaynaklar çelişkili bilgiler sunuyor. İşte heriki görüş…”
- “Bu bilgi2023 tarihli; güncel durumudoğrulamak için ek araştırma gerekebilir.”
Pro İpucu: Kullanıcıya sunulan her kritik bilginin yanına bir “güven skoru” eklemek, şeffaflığı artırır ve kullanıcının kendi değerlendirmesini yapmasına olanak tanır.
3. Grounding (Temellendirme) Teknikleri
Google Cloud’un Vertex AI platformu gibi modern sistemler, RAG (Retrieval-Augmented Generation) tekniklerini “grounding” yani temellendirme için kullanıyor. Bu yaklaşımda model, önce soruyla ilgili gerçekleri güvenilir kaynaklardan çekiyor, ardından bu gerçeklere dayanarak yanıt üretiyor.
Temellendirme, halüsinasyonları azaltmanın en etkili yollarından biri. Çünkü model artık “hafızasından” değil, doğrulanmış kaynaklardan besleniyor.
RAG vs Fine-Tuning: Doğruluk İçin Hangisi Daha Etkili?
Yapay zeka ajanlarını eğitirken iki ana yaklaşım öne çıkıyor: RAG ve ince ayar (fine-tuning). Doğruluk odaklı tasarımda hangisinin daha uygun olduğu, kullanım senaryosuna göre değişir.
| Kriter | RAG | Fine-Tuning |
|---|---|---|
| Bilgi güncelliği | Yüksek (anlık güncelleme) | Düşük (yeniden eğitim gerekir) |
| Doğruluk kontrolü | Kaynak bazlı doğrulama mümkün | Model içi, izlemesi zor |
| Halüsinasyon riski | Düşük (kaynak bağımlı) | Orta-Yüksek |
| Maliyet | Altyapı maliyeti (vektör DB) | Eğitim maliyeti (GPU/TPU) |
| Alan uzmanlığı | Dokümantasyona bağlı | Model davranışına işlenmiş |
Kilit Çıkarım: Doğruluk öncelikli sistemlerde RAG genellikle daha güvenli bir seçim. Çünkü her yanıtın arkasındaki kaynak izlenebilir ve doğrulanabilir. Fine-tuning ise modelin “nasıl konuştuğunu” veya “hangi formatta yanıt verdiğini” şekillendirmek için daha uygun.
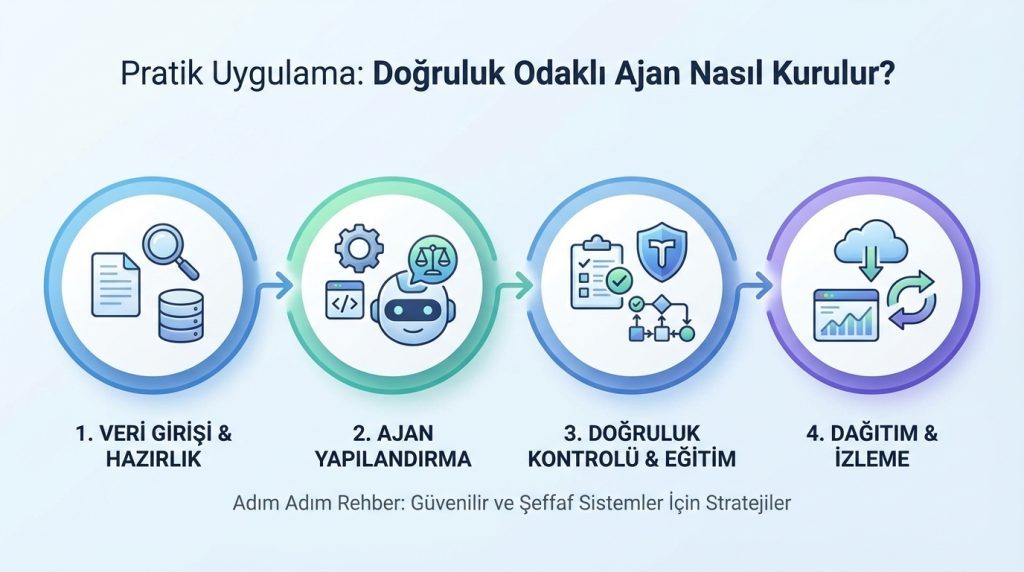
Pratik Uygulama: Doğruluk Odaklı Ajan Nasıl Kurulur?
Başlamadan Önce
Gerekenler:
- Bir LLM API erişimi (OpenAI, Anthropic, Google vb.)
- Vektör veritabanı (Pinecone, Weaviate, Chroma)
- Güvenilir kaynak havuzu (kurumsal dokümanlar, akademik veritabanları)
Ön Koşullar:
- Kaynaklarınızın güvenilirlik sınıflandırması yapılmış olmalı
- Çelişkili bilgi durumunda izlenecek protokol belirlenmiş olmalı
Adımlar
- Kaynak kataloğu oluştur: Tüm bilgi kaynaklarını güvenilirlik derecesine göre sınıflandır. Birincil kaynaklar (resmidokümanlar, akademik yayınlar) en yüksek önceliği alsın.
- Çapraz doğrulama mekanizması kur: Kritik bilgiler için en az iki bağımsız kaynaktan onay gerektiren bir sistem tasarla.
- Belirsizlik eşikleri belirle: Model, belirli bir güven skorunun altındaki bilgileri “kesin” olarak sunmasın. Bunun yerine belirsizliği açıkça ifade etsin.
- Geri bildirim döngüsü ekle: Kullanıcıların hatalı bilgileri raporlayabilmesini sağla. Bu geri bildirimler, kaynak güvenilirlik skorlarını güncellemek için kullanılsın.
- Düzenli denetim protokolü oluştur: Ajanın ürettiği yanıtları periyodik olarak örnekle ve doğruluk oranını ölç.
Yaygın Hatalar ve Kaçınılması Gerekenler
Doğruluk odaklı ajan tasarlarken sıkça yapılan hatalar şunlar:
- Tek kaynağa güvenmek: Ne kadar güvenilir olursa olsun, tek bir kaynak hata yapabilir. Çapraz doğrulama şart.
- Güncelliğidoğrulukla karıştırmak: “En son” bilgi her zaman “endoğru” bilgi değildir.
- Belirsizliği gizlemek: Kullanıcıya güven vermek için belirsizlikleri saklamak, uzun vadede güveni zedeler.
- Tüm konularda yanıt vermeye zorlamak:Ajan, uzmanlık alanıdışındaki konularda “bu konuda yeterli bilgim yok” diyebilmeli.
Sıkça Sorulan Sorular
Doğruluk odaklı tasarım, yanıt süresini yavaşlatır mı?
Evet, çapraz doğrulama ve kaynak kontrolü ek gecikme yaratır. Ancak bu gecikme genellikle milisaniyeler düzeyindedir ve kritik uygulamalarda kabul edilebilir bir takasoluşturur. Önbellek stratejileri ile bu etki minimize edilebilir.
RAG kullanmak halüsinasyonları tamamen ortadan kaldırır mı?
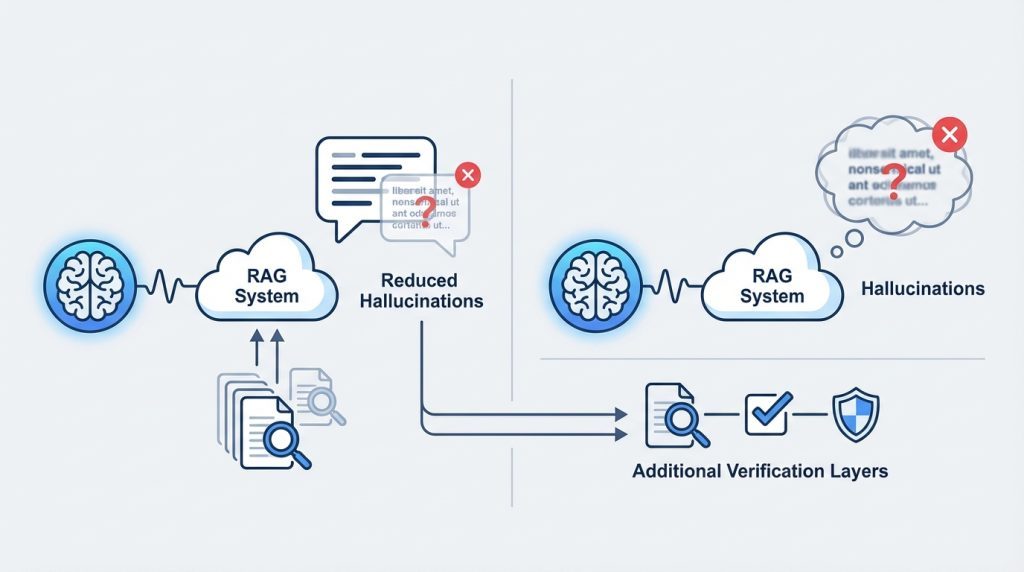
Hayır. RAG, halüsinasyon riskini önemli ölçüde azaltır ancak tamamen ortadan kaldırmaz. Model, kaynakları yanlış yorumlayabilir veya bağlamdan kopuk bilgi sunabilir. Bu nedenle ekdoğrulama katmanları gereklidir.
Küçük ölçekli projeler için bu yaklaşım çok mu karmaşık?
Temel prensipler herölçekteuygulanabilir. Başlangıç için kaynak güvenilirlik sınıflandırması ve belirsizlik ifadesi gibi düşük maliyetli adımlarla başlanabilir.
Sonuç
Yapay zeka ajanlarında doğruluk öncelikli tasarım, artık bir lüks değil zorunluluk. Kullanıcılar, ajanların her zaman doğru bilgi sunacağını varsayıyor; bu beklentiyi karşılayamamak hem güven kaybına hem de potansiyel zararlara yol açıyor.
Özetlemek gerekirse: Güncellik önemli, ancak doğruluk daha önemli. Kaynak doğrulama, çapraz kontrol, belirsizlik ifadesi ve temellendirme teknikleri, güvenilir bir ajan inşa etmenin temel taşları. RAG tabanlı sistemler, bu hedef için güçlü bir altyapı sunuyor. Unutmayın: Kullanıcınıza yanlış bilgi vermektense, “bu konuda emin değilim” demek her zaman daha değerlidir.