
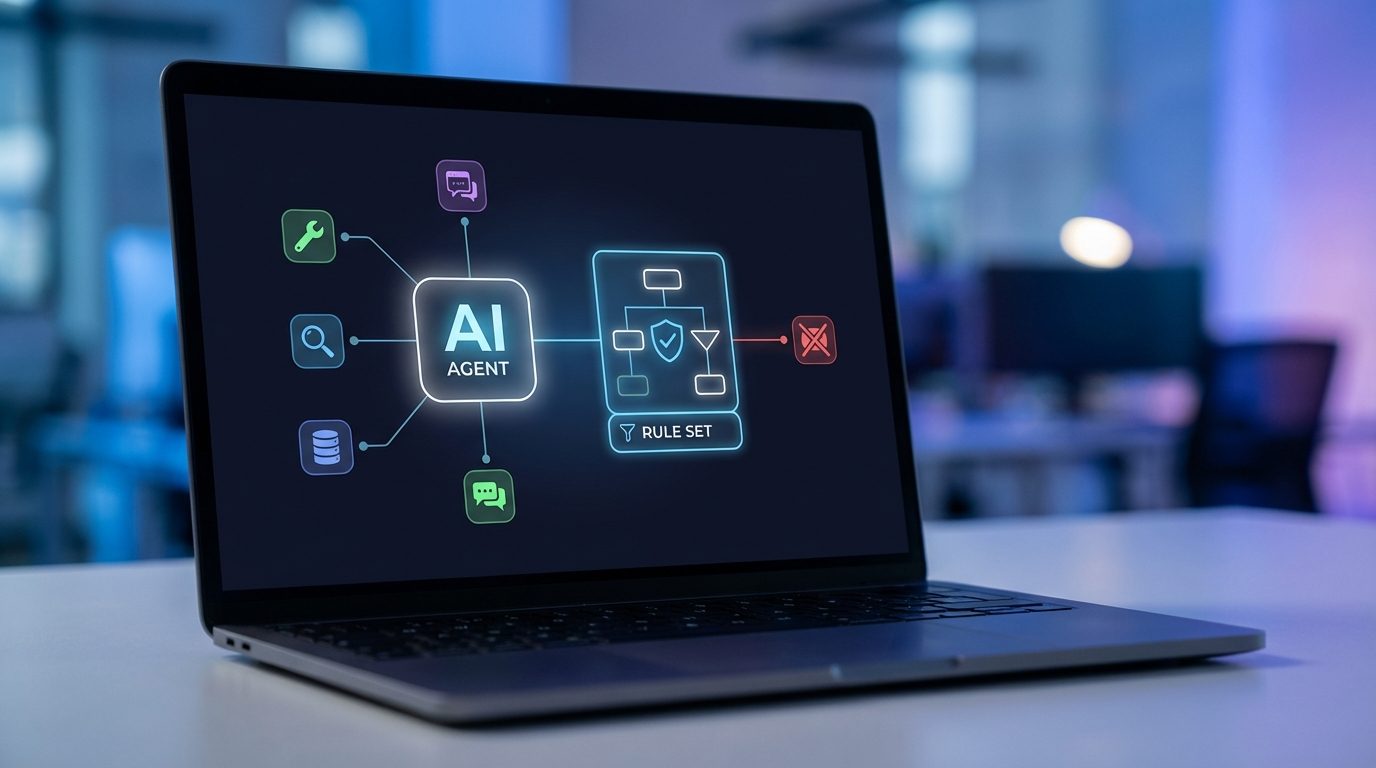
Bir yapay zeka ajanı geliştirdiniz, araçlarınızı (tools) tanımladınız, her şey hazır görünüyor. Ama test aşamasında fark ediyorsunuz: Ajan, “hava durumu sorgula” demesini beklediğiniz yerde “e-posta gönder” aracını çağırıyor. Ajanın yanlış aracı çağırmasını önlemek için kural seti kurgulama, modern LLM tabanlı sistemlerin en kritik mühendislik problemlerinden biri haline geldi. Doğru yapılandırılmış bir kural seti olmadan, ajanınız tahmin edilemez davranışlar sergileyebilir—ve bu durum üretim ortamında ciddi sorunlara yol açabilir.
Kilit Çıkarım: Araç seçim hataları genellikle belirsiz tanımlamalardan, çakışan işlevlerden veya bağlam eksikliğinden kaynaklanır. Çözüm, reaktif değil proaktif bir yaklaşım gerektirir.
Başlamadan Önce
Kural seti oluşturmaya geçmeden önce sisteminizin temel bileşenlerini netleştirmeniz gerekiyor. Eksik bir altyapıyla başlamak, sonradan çok daha büyük refaktör maliyetlerine neden olur.
Gerekenler:
- Çalışan bir LLM entegrasyonu (OpenAI, Anthropic, Gemini vb.)
- Tanımlanmış araç (function/tool) listesi
- Test senaryoları için örnek kullanıcı girdileri
- Loglama altyapısı (hangi aracın ne zaman çağrıldığını izlemek için)
Ön Koşullar:
- Araçlarınızın her birinin net bir “tek sorumluluk” ilkesine sahip olması
- Prompt mühendisliği temellerine hakimiyet
- JSON Schema veya benzeri bir yapılandırma formatı bilgisi
Yanlış Araç Seçiminin Kök Nedenleri
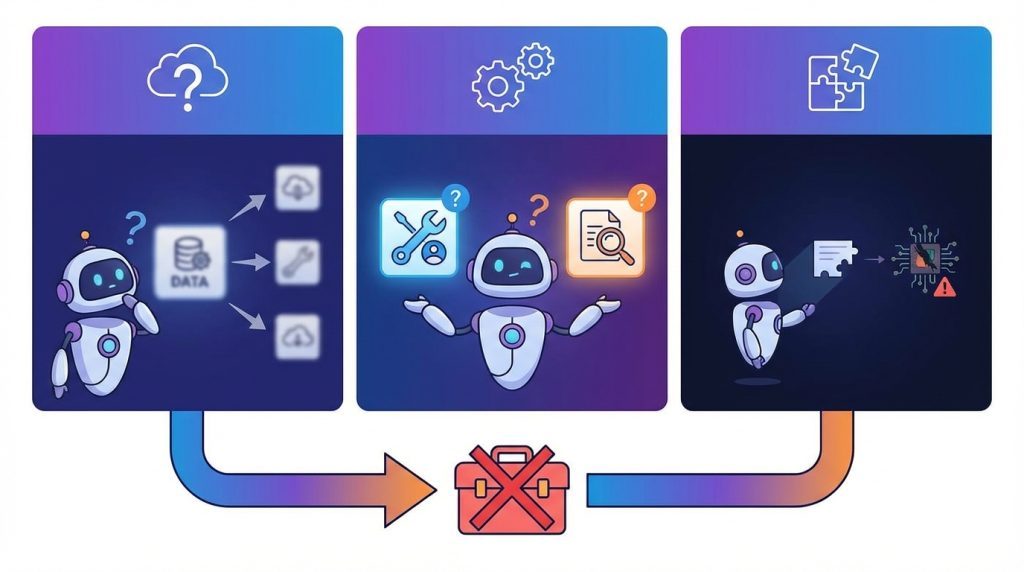
Pratikte en sık görülen hata kaynakları şunlar:
1. Belirsiz Araç Tanımlamaları: “Veri getir” gibi genel bir açıklama, LLM’in hangi veriyi nereden getireceğini anlamasını zorlaştırır. Araç açıklamaları ne kadar spesifik olursa, seçim doğruluğu o kadar artar.
2. Çakışan İşlev Alanları: İki aracın benzer işlevleri varsa (örneğin “kullanıcı_bilgisi_getir” ve “profil_sorgula”), model hangisini seçeceğine karar veremez. Bu durum, özellikle araç sayısı arttıkça kritik hale gelir.
3. Bağlam Yetersizliği: Kullanıcı girdisi tek başına yeterli ipucu vermiyorsa, ajan varsayımlara dayalı seçim yapar. “Bunu kontrol et” gibi belirsiz komutlar, hatalı araç çağrılarının ana tetikleyicisidir.
Risk Seviyesi: Yanlış araç çağrısı, veri sızıntısından istenmeyen işlemlere kadar geniş bir risk yelpazesi oluşturur. Özellikle yazma/silme yetkisi olan araçlarda bu risk katlanarak artar.
Kural Seti Kurgulama: Adım Adım
Şimdi somut bir kural seti oluşturma sürecine geçelim. Bu adımları sırasıyla uygula:
- Araç envanteri çıkar: Tüm araçlarını listele. Her birinin adı, açıklaması, parametreleri ve yan etkileri (side effects) net olmalı. Bir araç veri yazıyorsa, bunu açıkça belirt.
- Araç grupları oluştur: Benzer işlevleri kategorize et. Örneğin: “Okuma Araçları”, “Yazma Araçları”, “Dış Servis Araçları”. Bu gruplama, çakışmaları tespit etmeni kolaylaştırır.
- Tetikleyici koşulları tanımla: Her araç için “bu araç YALNIZCA şu koşullarda çağrılmalı” kuralları yaz. Örnek:
send_emailaracı yalnızca kullanıcı açıkça “e-posta gönder”, “mail at” veya benzeri bir ifade kullandığında tetiklenmeli. - Negatif kurallar ekle: “Bu araç şu durumlarda ASLA çağrılmamalı” listesi oluştur. Negatif kurallar, pozitif kurallar kadar önemli. Örnek:
delete_useraracı, kullanıcı onayı olmadan asla çağrılmamalı. - Öncelik sıralaması belirle: Birden fazla araç uygun görünüyorsa hangi kriterlere göre seçim yapılacağını tanımla. Genellikle “en az yan etkili” veya “en spesifik” araç tercih edilmeli.
- Guardrail katmanı ekle: LLM’in kararını doğrulayan ikincil bir kontrol mekanizması kur. Bu, kural tabanlı (regex, keyword matching) veya başka bir LLM çağrısı olabilir.
Pro İpucu: OpenAI’ın güncel rehberlerinde önerilen yaklaşım, LLM tabanlı ve kural tabanlı guardrail’leri paralel çalıştırmak. Böylece hem semantik anlama hem de kesin kural eşleştirme avantajlarından yararlanırsın.
Etkili Araç Tanımlama Şablonu
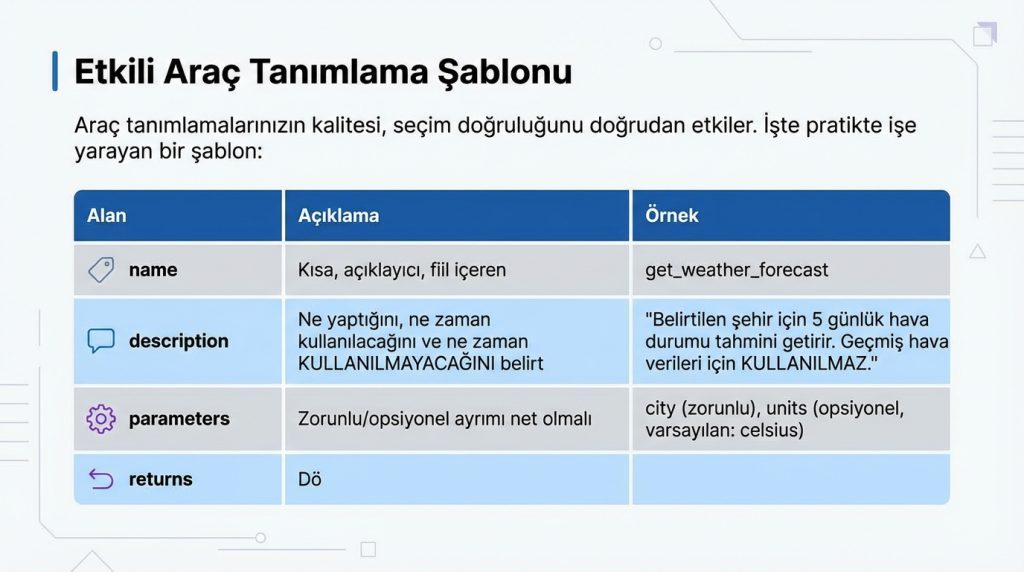
Araç tanımlamalarınızın kalitesi, seçim doğruluğunu doğrudan etkiler. İşte pratikte işe yarayan bir şablon:
| Alan | Açıklama | Örnek |
|---|---|---|
| name | Kısa, açıklayıcı, fiil içeren | get_weather_forecast |
| description | Ne yaptığını, ne zaman kullanılacağını ve ne zaman KULLANILMAYACAĞINI belirt | “Belirtilen şehir için 5 günlük hava durumu tahmini getirir. Geçmiş hava verileri için KULLANILMAZ.” |
| parameters | Zorunlu/opsiyonel ayrımı net olmalı | city (zorunlu), units (opsiyonel, varsayılan: celsius) |
| returns | Dönüş tipini ve yapısını açıkla | JSON objesi: {temp, humidity, forecast[]} |
| side_effects | Yazma, silme, dış API çağrısı varsa belirt | “Salt okunur, yan etkisi yok” |
Süre: İyi yapılandırılmış bir araç tanımlaması, başlangıçta 15-20 dakika ekstra zaman alır. Ancak bu yatırım, hata ayıklama süresinden katbekat tasarruf sağlar.
Çok Araçlı Sistemlerde Yaygın Tuzaklar
Araç sayısı arttıkça karmaşıklık da artar. Şu hatalara düşmemeye dikkat et:
- Araç enflasyonu: Her küçük işlev için ayrı araç tanımlamak, seçim zorluğunu artırır. Mümkünse ilgili işlevleri tek araçta parametrelerle yönet.
- Tutarsız isimlendirme:
getUser,fetch_profile,retrieve-datagibi farklı konvansiyonlar, LLM’i şaşırtır. Tek bir isimlendirme standardına sadık kal. - Eksik hata senaryoları: Araç başarısız olduğunda ne olacağını tanımlamamak, ajanın sonsuz döngüye girmesine neden olabilir.
- Aşırı güven: “LLM zaten anlayacaktır” varsayımı, üretimde en çok hayal kırıklığı yaratan yaklaşım. Her şeyi açıkça belirt.
Test ve Doğrulama Stratejileri
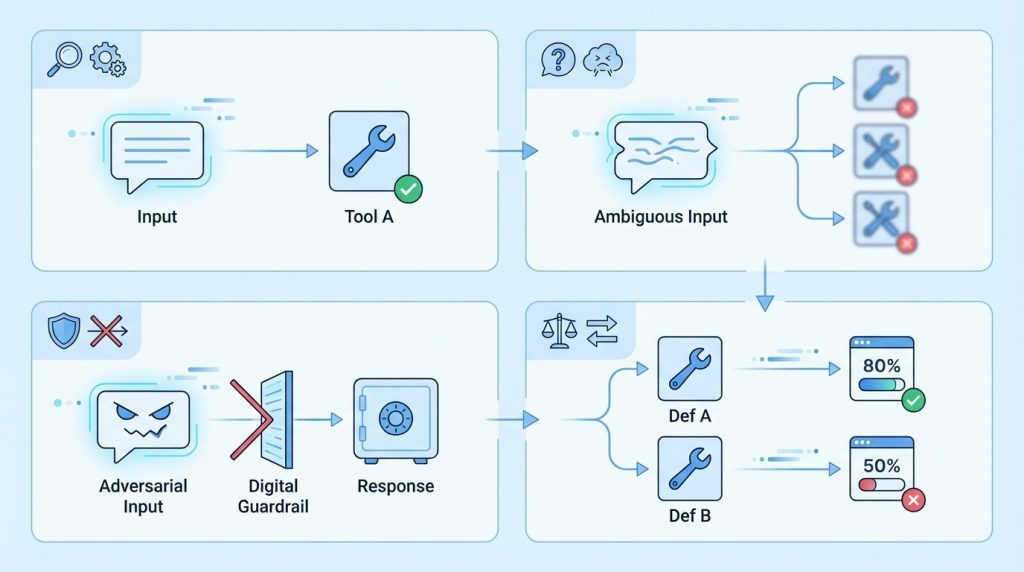
Kural setini oluşturduktan sonra sistematik test şart. Şu yaklaşımı uygulayabilirsin:
- Birim testleri: Her araç için “bu girdi → bu araç çağrılmalı” şeklinde test senaryoları yaz.
- Kenar durumları: Belirsiz, çok anlamlı veya eksik girdilerle sistemi zorla. “Bunu yap” gibi komutlarda ne oluyor?
- Adversarial testler: Kasıtlı olarak yanlış araca yönlendirecek girdiler dene. Guardrail’ler devreye giriyor mu?
- A/B karşılaştırması: Farklı araç tanımlamalarının seçim doğruluğunu ölç. Hangisi daha iyi sonuç veriyor?
Pro İpucu: Her araç çağrısını logla ve düzenli olarak analiz et. Hangi araçlar en çok yanlış çağrılıyor? Bu veri, kural setini iyileştirmek için altın değerinde.
Sıkça Sorulan Sorular
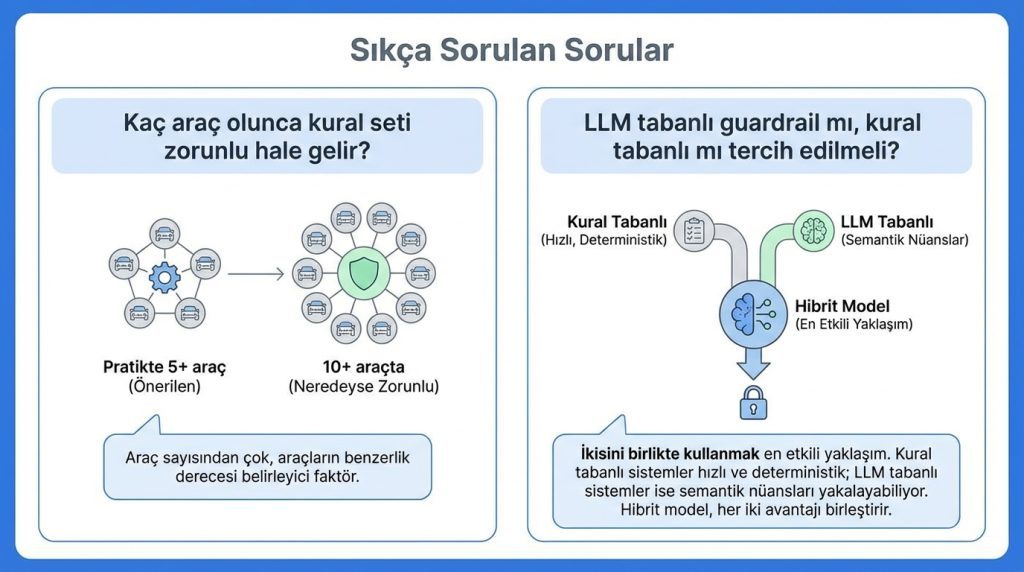
Kaç araç olunca kural seti zorunlu hale gelir?
Pratikte 5+ araç varsa yapılandırılmış bir kural seti önerilir. 10+ araçta ise neredeyse zorunlu. Ancak araç sayısından çok, araçların benzerlik derecesi belirleyici faktör.
LLM tabanlı guardrail mı, kural tabanlı mı tercih edilmeli?
İkisini birlikte kullanmak en etkili yaklaşım. Kural tabanlı sistemler hızlı ve deterministik; LLM tabanlı sistemler ise semantik nüansları yakalayabiliyor. Hibrit model, her iki avantajı birleştirir.
Araç tanımlamaları ne sıklıkla güncellenmelidir?
Her yeni araç eklendiğinde mevcut tanımlamaları gözden geçir. Ayrıca hata loglarını haftalık analiz edip, tekrarlayan yanlış seçimlerde tanımlamaları revize et.
Yanlış araç çağrısı üretimde gerçekleşirse ne yapmalı?
Önce işlemi geri al (mümkünse). Sonra logu incele: Hangi girdi bu seçime yol açtı? Kural setinde bu senaryoyu kapsayan bir kural var mıydı? Eksikse ekle, varsa neden çalışmadığını araştır.
Sonuç
Yapay zeka ajanlarında araç seçim doğruluğu, sistemin güvenilirliğini doğrudan belirler. Etkili bir kural seti için şu adımları hatırla:
- Araç tanımlamalarını spesifik ve açık yap—ne zaman kullanılacağını VE kullanılmayacağını belirt
- Çakışan işlevleri tespit et ve öncelik kuralları tanımla
- Hem pozitif hem negatif tetikleyici koşullar oluştur
- LLM ve kural tabanlı guardrail’leri birlikte kullan
- Sürekli logla, analiz et ve iyileştir
Maliyet: Başlangıçta ekstra mühendislik zamanı gerektirir. Ancak üretimdeki hata maliyetleriyle karşılaştırıldığında, bu yatırım kendini hızla amorti eder. Proaktif kural seti tasarımı, reaktif hata düzeltmeden her zaman daha ekonomiktir.