
Yapay zeka ajanlarınız gerçekten ne kadar iyi çalışıyor? “İyi görünüyor” veya “fena değil” gibi sübjektif değerlendirmeler, production ortamında sizi yarı yolda bırakır. Ajanların performansını ölçmek için değerlendirme harness kurma süreci, tam da bu belirsizliği somut verilere dönüştürmenin yoludur. Doğru bir harness ile hangi ajanın hangi görevde başarılı olduğunu, nerede tıkandığını ve optimizasyon için nerelere odaklanmanız gerektiğini net biçimde görebilirsiniz.
Kilit Çıkarım: Değerlendirme harness’ı, ajanlarınızı standart test senaryolarından geçiren, sonuçları ölçülebilir metriklerle raporlayan ve tekrarlanabilir karşılaştırmalar yapmanızı sağlayan bir test altyapısıdır.
Başlamadan Önce
Harness kurulumuna geçmeden önce elinizde olması gereken araçları ve karşılamanız gereken ön koşulları netleştirelim.
Gerekenler
- Python 3.9 veya üzeri kurulu bir geliştirme ortamı
- Test edilecek ajan(lar)ın API erişimi veya lokal çalıştırma imkânı
- Değerlendirme veri seti (benchmark dataset)
- Sonuçları kaydetmek için bir veritabanı veya JSON/CSV dosya sistemi
- Opsiyonel: GPU desteği (büyük modellerde hız için)
Ön Koşullar
- Ajanınızın hangi görevleri yerine getirdiğini net tanımlamış olmalısınız
- Başarı kriterlerinizi belirlemiş olmalısınız (doğruluk mu, hız mı, maliyet mi?)
- Test senaryolarınız için “ground truth” (doğru cevap) verileriniz hazır olmalı
- Temel Python ve komut satırı bilgisi
Değerlendirme Harness’ı Nedir ve Neden Önemli?
Evaluation harness, yapay zeka ajanlarını sistematik biçimde test eden bir çerçevedir. Tek seferlik manuel testlerin aksine, harness size tekrarlanabilirlik, karşılaştırılabilirlik ve ölçeklenebilirlik sağlar. Bir ajanı güncellediniz mi? Aynı test setini tekrar çalıştırıp önceki versiyonla kıyaslayabilirsiniz.
Güncel araştırmalar, ajan değerlendirmesinin sadece “görev tamamlama oranı”na bakmanın yetersiz kaldığını ortaya koyuyor. Kurumsal kullanımda güvenilirlik, maliyet verimliliği ve hata kurtarma kapasitesi gibi boyutlar da kritik önem taşıyor.
Ölçmeniz Gereken Temel Metrikler
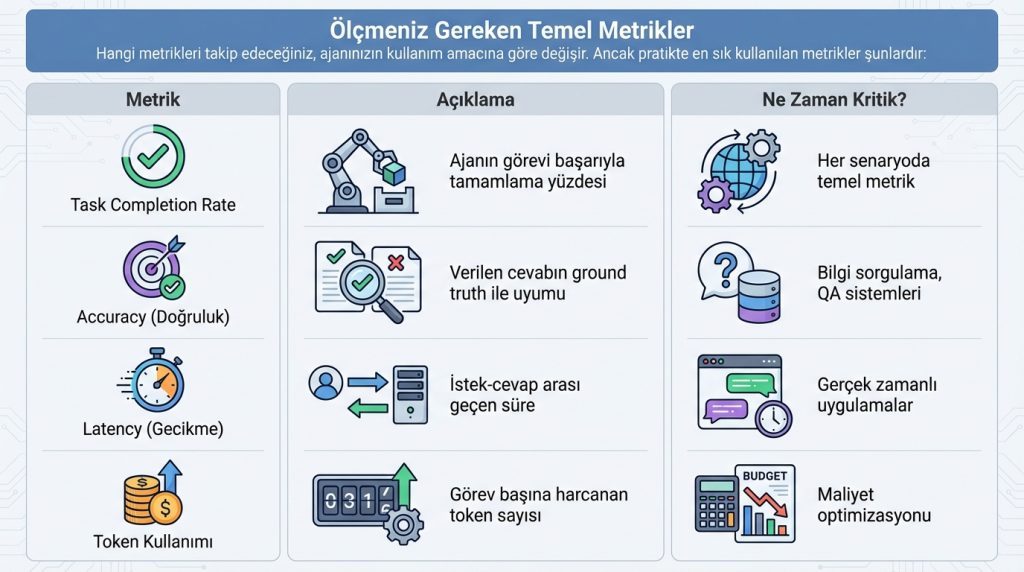
Hangi metrikleri takip edeceğiniz, ajanınızın kullanım amacına göre değişir. Ancak pratikte en sık kullanılan metrikler şunlardır:
| Metrik | Açıklama | Ne Zaman Kritik? |
|---|---|---|
| Task Completion Rate | Ajanın görevi başarıyla tamamlama yüzdesi | Her senaryoda temel metrik |
| Accuracy (Doğruluk) | Verilen cevabın ground truth ile uyumu | Bilgi sorgulama, QA sistemleri |
| Latency (Gecikme) | İstek-cevap arası geçen süre | Gerçek zamanlı uygulamalar |
| Token Kullanımı | Görev başına harcanan token sayısı | Maliyet optimizasyonu |
| Tool Call Accuracy | Ajanın doğru aracı doğru parametrelerle çağırma oranı | Araç kullanan ajanlar |
| Recovery Rate | Hata sonrası kendini toparlama başarısı | Otonom sistemler |
Pro İpucu: Tek bir metriğe takılma. Yüksek doğruluk ama aşırı yavaş bir ajan, production’da işe yaramaz. Metriklerinizi kullanım senaryonuza göre ağırlıklandırın.
Adım Adım Harness Kurulumu
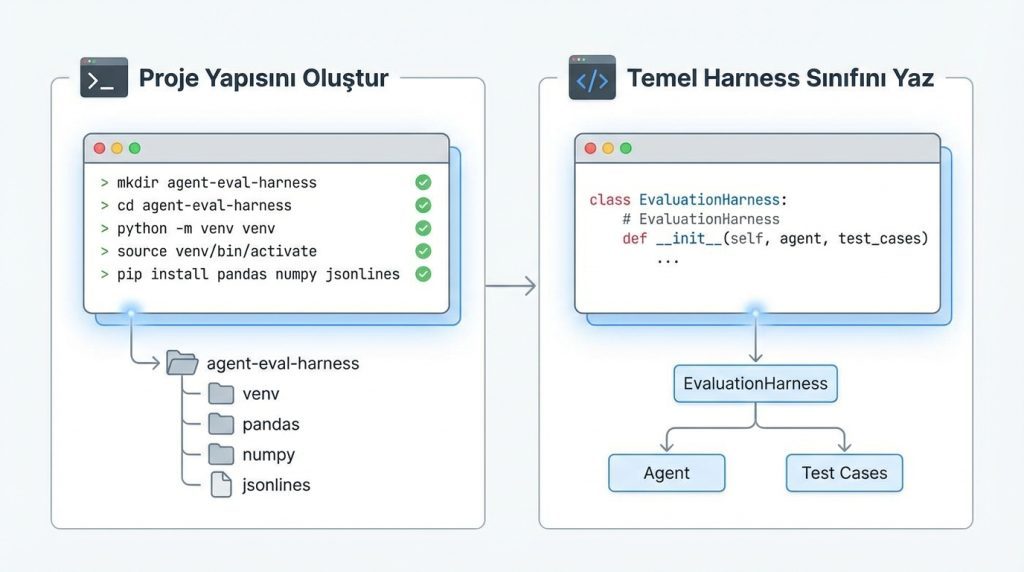
Şimdi pratik kuruluma geçelim. Bu rehberde Python tabanlı, modüler bir yapı oluşturacağız.
-
Proje yapısını oluştur:
Terminali aç ve şu komutları çalıştır:
mkdir agent-eval-harness cd agent-eval-harness python -m venv venv source venv/bin/activate # Windows: venvScriptsactivate pip install pandas numpy jsonlines -
Temel harness sınıfını yaz:
Aşağıdaki yapı, farklı ajanları ve test setlerini destekleyen esnek bir iskelet sunar:
class EvaluationHarness: def __init__(self, agent, test_cases): self.agent = agent self.test_cases = test_cases self.results = [] def run_evaluation(self): for case in self.test_cases: start_time = time.time() response = self.agent.execute(case["input"]) latency = time.time() - start_time result = { "case_id": case["id"], "expected": case["expected"], "actual": response, "correct": self.check_correctness(response, case["expected"]), "latency_ms": latency * 1000 } self.results.append(result) return self.calculate_metrics() -
Test veri setini hazırla:
JSON formatında test case’lerini tanımla. Her case için benzersiz ID, girdi, beklenen çıktı ve opsiyonel metadata ekle:
[ { "id": "task_001", "input": "İstanbul'un nüfusu kaç?", "expected": "yaklaşık 16 milyon", "category": "factual_qa" } ] -
Metrik hesaplama fonksiyonlarını ekle:
Doğruluk, ortalama latency ve başarı oranı için hesaplama metodlarını implement et.
-
Raporlama modülünü entegre et:
Sonuçları CSV veya JSON olarak dışa aktar. Görselleştirme için matplotlib veya bir dashboard aracı kullanabilirsin.
Popüler Değerlendirme Framework’leri
Sıfırdan harness yazmak istemiyorsanız, hazır çözümler de mevcut. İşte öne çıkan seçenekler:
EleutherAI lm-evaluation-harness
Açık kaynaklı ve topluluk tarafından aktif geliştirilen bu framework, 60’tan fazla benchmark’ı destekliyor. Kurulumu oldukça basit:
pip install lm_eval[hf]
lm_eval --model hf --model_args pretrained=gpt2 --tasks hellaswag
Özellikle dil modeli değerlendirmesinde standart haline gelmiş durumda.
AgentBoard
Çok turlu ajan etkileşimlerini değerlendirmek için tasarlanmış. Ajanın her adımda nasıl ilerlediğini takip edebiliyorsunuz. Araştırma odaklı projeler için ideal.
Özel Harness vs. Hazır Framework
| Kriter | Özel Harness | Hazır Framework |
|---|---|---|
| Esneklik | Tam kontrol | Sınırlı özelleştirme |
| Kurulum Süresi | Uzun (günler) | Kısa (saatler) |
| Bakım Yükü | Yüksek | Düşük |
| Benchmark Desteği | Manuel ekleme | Hazır entegrasyonlar |
Yaygın Hatalar ve Kaçınılması Gerekenler
- Tek metriğe odaklanmak: Sadece accuracy’ye bakmak, latency ve maliyet sorunlarını gizler.
- Test setini ezbere öğretmek: Ajanı test verileriyle eğitirseniz, gerçek performansı ölçemezsiniz.
- Deterministik olmayan testler: Aynı girdiyle farklı sonuçlar alıyorsanız, temperature ayarını sıfırlayın veya seed kullanın.
- Edge case’leri ihmal etmek: Sadece “mutlu yol” senaryolarını test etmek yanıltıcı sonuçlar verir.
Mini Senaryo: Şu Durumda Ne Yaparsın?
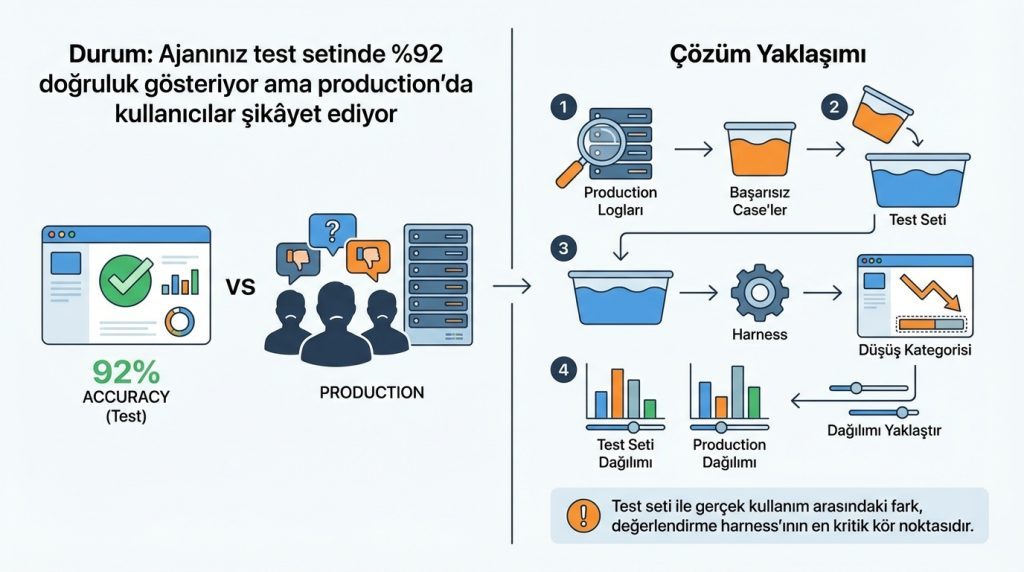
Durum: Ajanınız test setinde %92 doğruluk gösteriyor ama production’da kullanıcılar şikâyet ediyor.
Çözüm Yaklaşımı:
- Production loglarından başarısız case’leri topla
- Bu case’leri test setine ekle
- Harness’ı tekrar çalıştır ve hangi kategoride düşüş olduğunu tespit et
- Gerekirse test setini production dağılımına yaklaştır
Test seti ile gerçek kullanım arasındaki fark, değerlendirme harness’ının en kritik kör noktasıdır.
Sıkça Sorulan Sorular
Kaç test case’i yeterli?
Genel kural: Her görev kategorisi için en az 50-100 case. Ancak kritik uygulamalarda bu sayı binlere çıkabilir. Önemli olan çeşitlilik ve temsil gücüdür.
Değerlendirmeyi ne sıklıkla çalıştırmalıyım?
Her model güncellemesinden sonra ve düzenli aralıklarla (haftalık/aylık). CI/CD pipeline’ına entegre etmek en sağlıklı yaklaşımdır.
LLM-as-a-judge yaklaşımı güvenilir mi?
Subjektif değerlendirmeler (ton, yaratıcılık) için kullanışlı olabilir. Ancak faktüel doğruluk için ground truth karşılaştırması hâlâ altın standarttır.
Özetle
Ajan performansını ölçmek için değerlendirme harness’ı kurmak, yapay zeka projelerinde “hissiyat”tan “veri”ye geçişin anahtarıdır. Temel adımları özetleyelim:
- Önce başarı kriterlerinizi ve metriklerinizi netleştirin
- Temsil gücü yüksek bir test seti oluşturun
- Modüler bir harness yapısı kurun veya hazır framework kullanın
- Sonuçları düzenli takip edin ve test setinizi güncel tutun
- Tek metriğe değil, çok boyutlu değerlendirmeye odaklanın
Süre: Temel bir harness kurulumu 1-2 gün, kapsamlı bir sistem 1-2 hafta sürebilir.
Risk Seviyesi: Düşük – test ortamında çalıştığınız için production’ı etkilemez.
Maliyet: Açık kaynak araçlarla sıfır; bulut API kullanıyorsanız test başına token maliyeti hesaba katılmalı.